


Meilleurs outils de web scraping IA benchmarkés

Les sites modifient leur mise en page et les champs dont vous avez besoin sur une page évoluent au fil du temps. Ces changements cassent les scrapers codés manuellement. Les scrapers IA peuvent être mis à jour avec de simples prompts, et certains peuvent réparer un scraper enregistré lorsque le site change.
Nous avons benchmarké les meilleurs outils de web scraping IA sur les 10 principaux domaines e-commerce pour évaluer leurs performances, et avons également comparé la manière dont chacun exploite l'IA.
Le classement repose sur le taux de réussite pour les fournisseurs benchmarkés, et sur la couverture fonctionnelle pour les autres.
Benchmark des outils de web scraping IA
Chaque fournisseur adopte une approche différente de l'IA, et notre objectif était de comparer ces approches et les compromis qu'elles impliquent. Consultez la section méthodologie du benchmark pour plus de détails sur le processus de test.
Les données de prix et de devise ont été extraites des 10 principaux sites e-commerce mondiaux.
Principaux enseignements sur les outils de web scraping IA issus du benchmark
- Les échecs reviennent sous forme de données. Lorsqu'un outil ne peut pas lire un prix, souvent parce que la page a déclenché un mur anti-bot, la réponse peut revenir sous forme de 0 plutôt que d'un échec. Une valeur null peut être réessayée ou ignorée ; un 0 passe la validation sans être remarqué. Par exemple, Apify et Oxylabs ont renvoyé null dans ces cas, et la documentation de Firecrawl recommande d'ajouter « Renvoyez null si la valeur n'est pas trouvée sur la page » à chaque champ du schéma afin que le modèle ne devine pas de valeur.
- Des champs supplémentaires arrivent sans être invités. Demandez le prix et la devise et vous pouvez aussi recevoir la marque, la description ou des URL d'images. Un schéma limite la réponse aux champs que vous nommez. Par exemple, Bright Data vous permet de verrouiller le schéma de sortie au moment de la construction, afin que la même forme soit renvoyée à chaque appel.
- Le mauvais élément est extrait. Prix remisé contre prix d'origine, avec taxes contre hors taxes, bascules régionales : l'outil peut saisir le nombre que vous ne vouliez pas.
- Les nombres dérivent. Les outils de prompt vers JSON peuvent ajouter des décimales, tronquer des valeurs ou renvoyer des approximations converties en devises qui n'apparaissent nulle part sur la page.
- La localisation change la réponse. Certains sites fixent les prix en fonction de la géolocalisation IP, de sorte qu'un fournisseur utilisant des proxies américains voit un nombre là où un utilisateur européen voit un autre.
Le schéma et la région du proxy sont les paramètres qui vous permettent de détecter la plupart de ces problèmes avant qu'ils n'atteignent vos données.
Tarification des outils de web scraping IA
Kadoa ne publie aucun tarif, proposant une offre Flex basée sur la consommation et une offre Enterprise sur contact commercial.
Comparaison des outils de web scraping IA
Délai pour le premier scraper : Pour les outils qui construisent un scraper que vous appelez ensuite par ID, combien de temps prend la configuration. « Appel HTTP unique » signifie qu'il n'y a aucune étape de construction.
Schéma de sortie défini par l'utilisateur : Indique si vous pouvez définir vous-même les champs de sortie et leurs types avant l'exécution du scraping, au lieu de les décrire dans un prompt et de laisser le LLM décider de la structure au moment de l'exécution.
Endpoint à construction unique et appels multiples : Indique si le scraper est construit une seule fois, stocké côté fournisseur, puis appelé avec une simple URL. Ici, le LLM (ou, pour les outils basés sur l'enregistrement, votre parcours de clics) s'exécute au moment de la construction et sa sortie est figée dans un scraper que vous possédez et pouvez modifier sur place, auquel s'attachent les planifications, les webhooks et les intégrations. Lorsque cela manque, l'extraction est recalculée à chaque appel et la définition complète voyage avec chaque requête.
Scraper enregistré auto-réparateur : Indique si un scraper enregistré est réparé lorsque le site cible change, sans le reconstruire à partir de zéro. La correction s'applique au même scraper stocké sous son identifiant existant, afin que les déclencheurs, les planifications et les intégrations continuent de fonctionner.
* Kadoa stocke le scraper et l'appelle par ID, mais les URL cibles sont liées lors de la création du workflow. Pour le pointer vers une nouvelle URL, il faut effectuer une mise à jour distincte des métadonnées avant l'exécution.
Les outils qui exécutent un LLM sur la page à chaque appel ne sont pas comptés ici : il n'existe aucune logique d'extraction persistante à réparer, ce qui les rend tolérants aux changements de mise en page, mais signifie aussi qu'il n'y a aucun artefact à inspecter, versionner ou approuver. De même, les caches internes sans identifiant que vous puissiez cibler ne sont pas comptés, car là encore, il n'y a rien à inspecter, versionner ou approuver.
Au-delà des pages qui changent constamment, dans les pipelines agentiques, vous avez souvent besoin d'une API simple que vous pouvez appeler : donnez une URL, recevez des données structurées en retour. Mais vous ne trouvez pas toujours une API de scraper prête pour chaque domaine que vous devez scraper régulièrement ; et même quand c'est le cas, les champs souhaités peuvent ne pas y être, ou vous devez personnaliser le schéma selon vos propres besoins. Il existe différentes approches pour répondre à ces problèmes.
Plateformes de web scraping IA à construction unique et appels multiples
Si vous construisez votre propre scraper, vous devez écrire le crawler, configurer les proxies, exécuter des navigateurs headless et gérer vous-même les files d'attente, les nouvelles tentatives et l'anti-bot.
L'IA s'est invitée dans le scraping pour réduire ce travail manuel et simplifier la configuration. Elle est présente dans la plupart de ces outils, mais chaque fournisseur l'utilise différemment et répond à un ensemble de besoins différent.
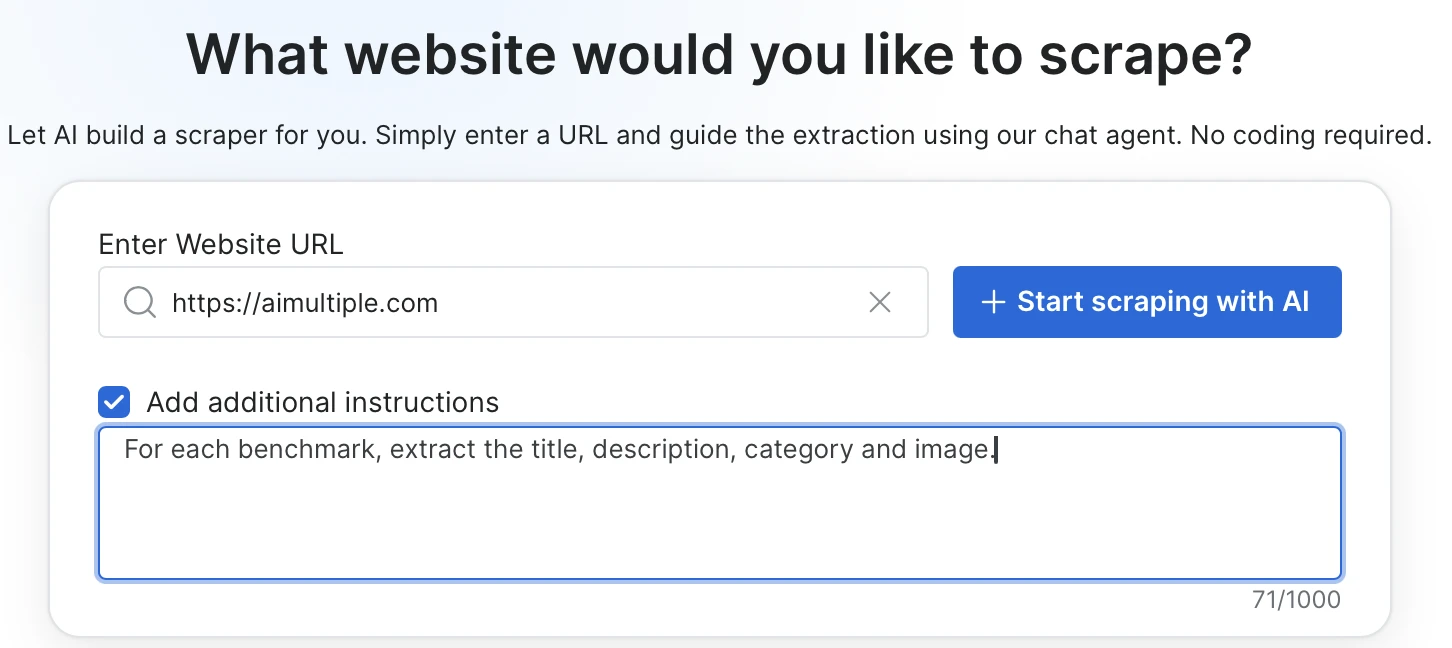
Bright Data Scraper Studio propose une approche en deux phases : vous construisez le scraper pour n'importe quelle URL à l'aide d'un prompt, puis vous l'appelez en tant qu'API stable. Vous le configurez une seule fois, puis vous contentez de transmettre des URL.
Vous décrivez les champs que vous souhaitez extraire en langage naturel, et vous pouvez éventuellement ajouter des sélecteurs CSS, des actions requises sur la page ou un comportement de chargement de page.
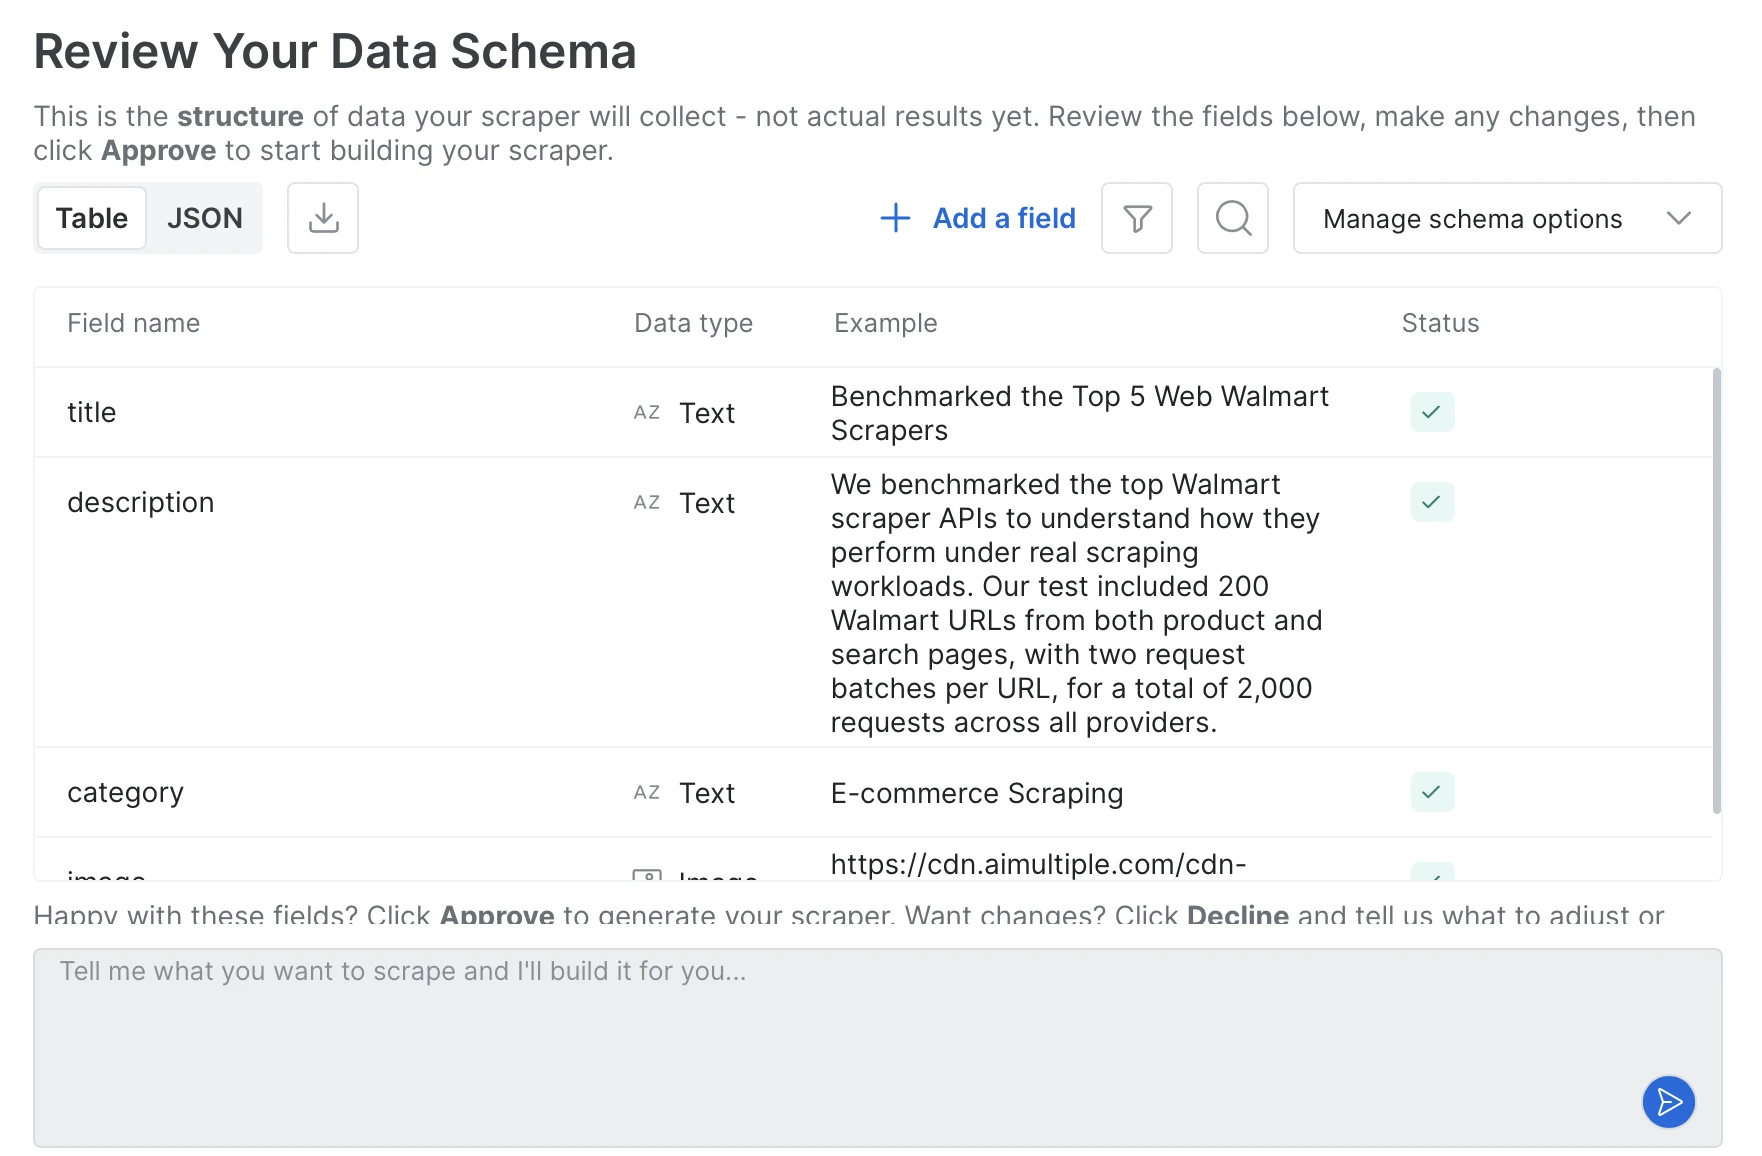
L'agent génère le schéma de sortie à partir du prompt ; vous l'approuvez en ajoutant ou supprimant des champs ou en modifiant les types, puis le code du scraper est écrit.
- Endpoint à construction unique et appels multiples : Une fois le schéma approuvé, le scraper est enregistré comme un endpoint de longue durée avec un identifiant fixe. Chaque appel atteint le même endpoint avec une simple URL, et le schéma de sortie reste identique d'un appel à l'autre. Lors de nos tests, la construction d'un scraper dédié a pris environ 10 minutes en moyenne.
- Deux méthodes de construction : Vous pouvez discuter avec l'Agent dans le navigateur, ou utiliser la CLI Bright Data pour construire le scraper depuis votre terminal avec une seule commande qui prend une URL et un prompt. Les deux produisent le même scraper.
- Workflow d'agent de codage : Les commandes de terminal s'exécutent telles quelles dans Claude Code, Cursor et Codex, afin que l'agent puisse construire, exécuter ou auto-réparer un scraper sans quitter l'éditeur. Vous pouvez également épingler l'identifiant du scraper dans le fichier de règles de l'agent afin que les sessions futures le réutilisent. Les résultats peuvent être livrés via API, SDK, CLI, webhooks, ou directement vers le stockage cloud sur S3, GCS, Azure ou OSS.
- Combiné à des scrapers prêts à l'emploi : Bright Data maintient une bibliothèque de scrapers prêts pour des sites populaires comme Amazon, LinkedIn et Zillow.
- Scraper enregistré auto-réparateur : Lorsque le site change et que le scraper tombe en panne, vous décrivez en langage naturel ce qui s'est cassé ; l'IA produit une correction et la montre avec un exemple de sortie, et rien n'est mis en production avant votre approbation. Comme l'identifiant du scraper ne change pas, chaque déclencheur, planification et intégration qui y est lié continue de fonctionner.
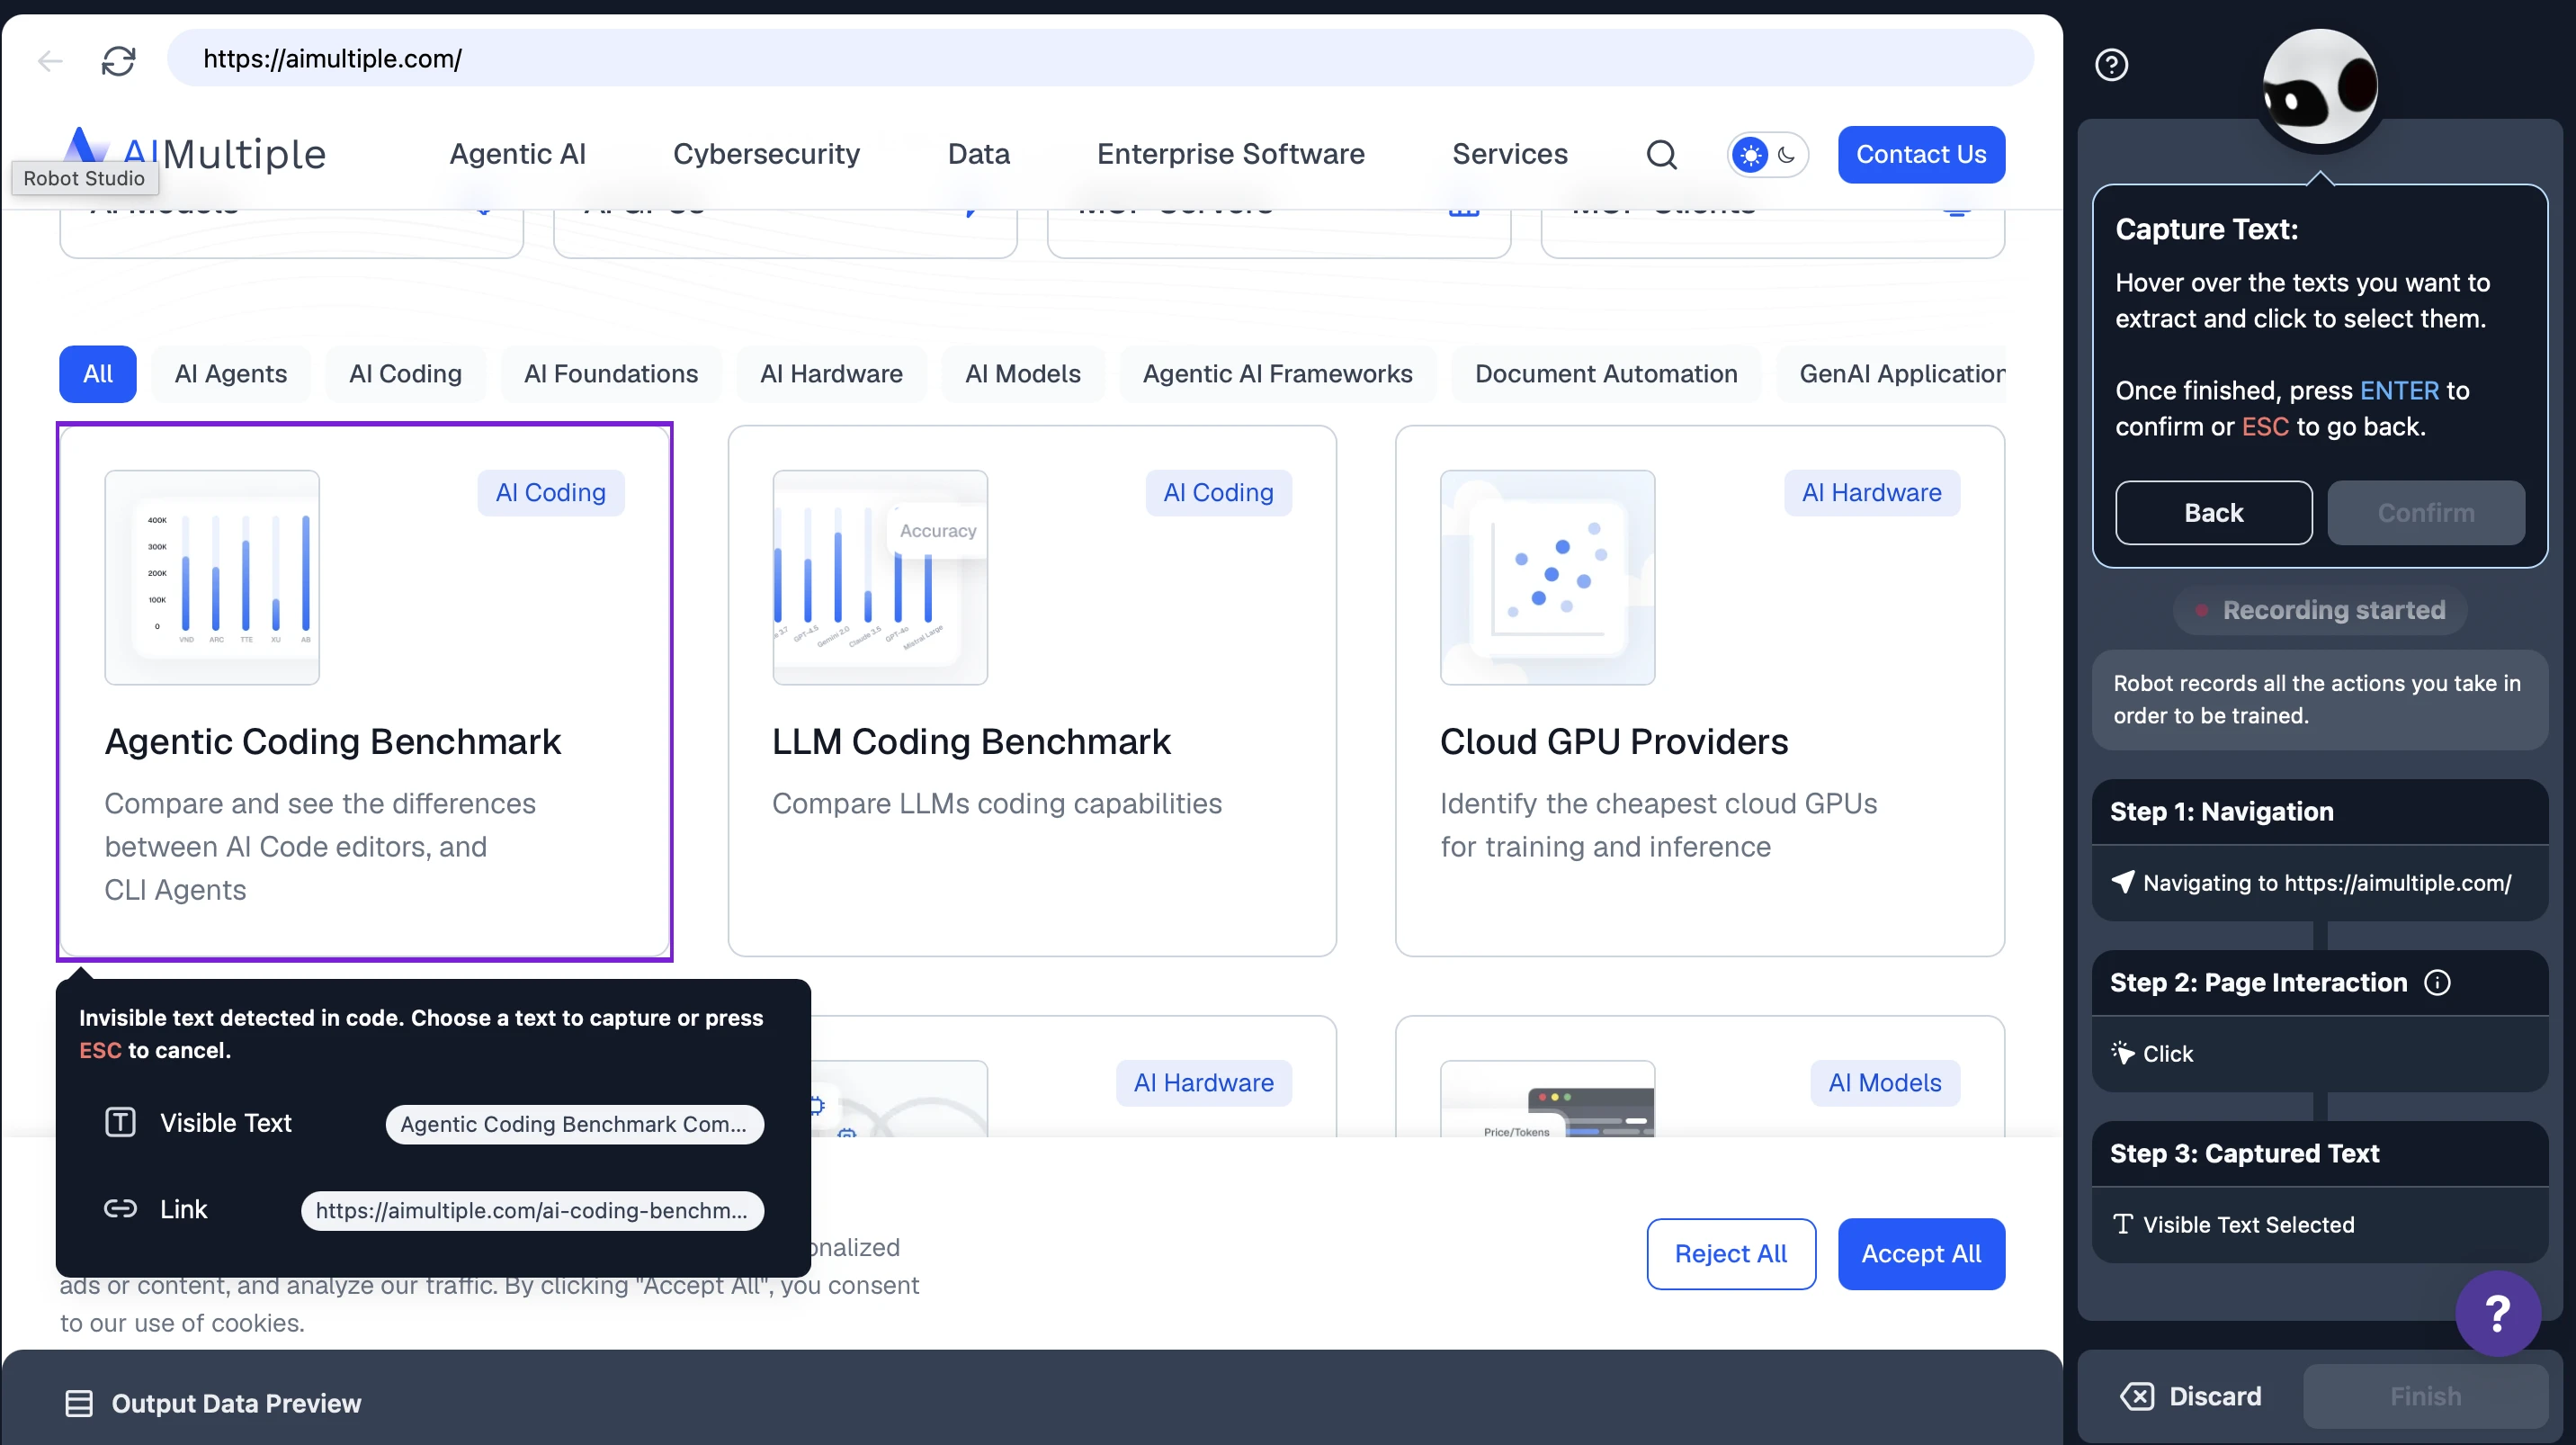
Dans Browse IA, vous construisez toujours le scraper vous-même, mais la configuration est visuelle : vous rendez sur la page cible et cliquez pour marquer les champs à capturer, et le robot enregistre les étapes de navigation ainsi que les champs sélectionnés comme un enregistrement. Cet enregistrement s'exécute ensuite encore et encore ; lorsque la page change, le robot s'adapte de lui-même dans la plupart des cas, et il est réentraîné lorsque cela n'est pas possible.
- Configuration visuelle avec Robot Studio : Les scrapers sont construits avec un flux clic → capture du champ → enregistrement.
- Surveillance et alertes intégrées : Planifications horaires, quotidiennes ou hebdomadaires + détection des changements + alertes par e-mail/webhook dans le même produit.
- Le schéma est formé à partir des champs capturés : Une étape de capture distincte est ajoutée pour chaque champ ; pas de génération de schéma à partir d'un prompt.
- Adaptation automatique : Le moteur de Browse IA adapte le code de scraping lorsqu'un site change, et la plupart des robots continuent de fonctionner sans intervention. Lorsque l'adaptation ne suffit pas, vous réentraînez le robot, ce qui préserve son historique, ses exécutions et ses workflows.
Kadoa construit également le scraper à partir d'un prompt, mais lie les URL cibles lors de la création du workflow au lieu de les accepter à chaque appel. Ce qu'il stocke est du code généré plutôt qu'un prompt, ce qui donne un artefact concret à surveiller et à réparer.
- Endpoint à construction unique et appels multiples : Un workflow enregistré reçoit un ID persistant et est appelé avec
PUT /v4/workflows/{id}/run. La requête ne transporte que des variables et une limite de lignes ; le schéma et le code d'extraction restent du côté de Kadoa. Pointer le même workflow vers une URL différente nécessite d'abord de mettre à jour ses métadonnées, ce n'est donc pas un appel unique contenant une URL. - Du prompt au schéma typé : Vous décrivez les données dans le prompt de configuration et Kadoa propose un schéma que vous modifiez dans une vue visuelle ou JSON. Les champs portent des types tels que STRING, NUMBER, MONEY, DATE et LINK, et peuvent être marqués comme clés.
- Scraper enregistré auto-réparateur : La réparation est déclenchée par une exécution échouée plutôt que par une planification. Kadoa régénère le code d'extraction et le valide par rapport aux données précédemment extraites, sous le même ID de workflow, afin que les planifications et les intégrations continuent de fonctionner. Il n'y a pas d'étape d'approbation avant que la correction ne soit mise en production. Lorsque la récupération automatique échoue, un ticket est transmis à l'équipe ops de Kadoa.
- Workflow d'agent de codage : Un serveur MCP hébergé avec plus de 40 outils, plus des SDK Node et Python officiels et une CLI (
kadoa create,kadoa run,kadoa export). - Livraison : API, SDK, CLI, MCP et Google Sheets pour l'extraction (pull) ; S3, GCS, Azure Blob, webhooks, WebSockets, e-mail et Slack pour l'envoi (push) ; Snowflake et Databricks pour le partage. Les connecteurs de stockage cloud sont configurés via le support plutôt qu'en libre-service.
APIs d'extraction IA one-shot
Oxylabs IA Studio est une suite de cinq applications d'IA distinctes sous un seul SDK (pip install oxylabs-ai-studio) : AiScraper, AiCrawler, BrowserAgent, AiSearch et AiMap. Rien n'est persisté côté serveur, chaque appel de scraping exécute une nouvelle récupération plus une extraction par LLM.
- Flux AiScraper : generate_schema(prompt=…) appelle éventuellement le LLM pour produire un schéma JSON, puis scrape(url, schema) récupère la page et exécute l'extraction par LLM. Vous pouvez conserver et réutiliser le schéma de votre côté, mais le serveur n'enregistre pas de scraper de longue durée.
- Cinq applications, un seul SDK : AiScraper pour l'extraction structurée d'une seule URL, AiCrawler pour le parcours de site piloté par prompt, BrowserAgent pour les actions sur la page, AiSearch pour la recherche en langage naturel plus l'extraction, et AiMap pour les cartes d'URL filtrées d'un site.
- Formats de sortie : markdown (par défaut), json, csv, toon (un format optimisé pour les tokens), screenshot et html (agent navigateur uniquement).
- Schémas écrits à la main :
generate_schemaest facultatif. Le paramètreschemaaccepte n'importe quel schéma JSON que vous écrivez, et les exemples d'Oxylabs transmettent un modèle Pydantic écrit à la main. Un schéma est obligatoire pour la sortie JSON, CSV et TOON. - Paramètres notables : render_javascript=« auto » permet au service de décider si le rendu JS est nécessaire, geo_location accepte un code pays ISO ou un nom pour la localisation du proxy, et max_credits définit un plafond de dépenses par requête.
Apify propose un écosystème de développeurs ouvert où les « Actors », programmes exécutables de scraping et d'automatisation, sont construits et exécutés sur sa plateforme. Vous pouvez écrire votre propre Actor à partir de zéro, partir d'un modèle prêt à l'emploi ou utiliser des Actors publiés par d'autres sur le Apify Store.
- Acteur d'extraction IA : Apify propose également un Actor prêt à l'emploi apify/ai-web-scraper qui prend un prompt en langage naturel et renvoie du JSON structuré à partir de n'importe quelle URL. Vous ressaisissez le prompt à chaque exécution, et la sortie JSON n'est pas garantie de rester cohérente entre les appels, ce qui est un comportement courant pour les outils pilotés par prompt.
- Prompt uniquement : L'entrée de l'Actor comporte cinq champs :
startUrls,extractionMode,prompt,maxPagesToVisitetmaxCrawlDepth. Il n'existe aucun paramètre pour un schéma de sortie défini par l'utilisateur. - Construisez votre propre actor : S'il n'existe aucun scraper prêt pour votre site cible ou si aucun d'eux ne scrape les champs de données que vous souhaitez, vous écrivez votre propre Actor et décidez quels champs extraire, où ils se trouvent sur la page et comment gérer le reste. La durée de cette opération dépend de vos compétences en codage et de la complexité du site. Si vous préférez ne pas le construire vous-même, vous pouvez également obtenir de l'aide auprès des services professionnels d'Apify.
- Combiné à des scrapers prêts à l'emploi : Une marketplace où les développeurs publient leurs propres Actors. Les scrapers pour les sites populaires sont principalement publiés et maintenus par des tiers.
- Services de la plateforme : Les Actors sont livrés avec planification, surveillance, stockage de datasets, pool de proxies et accès API prêts à l'emploi.
- Accès d'agent, pas de création d'agent : Le serveur MCP d'Apify permet à un agent de codage de rechercher et d'exécuter des Actors, mais il n'existe aucun flux intégré pour construire ou maintenir un Actor depuis l'agent.
- Responsabilité de la maintenance : Si vous avez construit l'Actor vous-même, vous le corrigez lorsque le site change. Si vous en utilisez un du Store, vous attendez que le propriétaire de l'Actor livre la correction selon son propre calendrier.
Firecrawl transforme une URL plus un prompt ou un schéma JSON en JSON en un seul appel synchrone. Chaque requête exécute le pipeline d'extraction au moment où l'appel est effectué.
- Prompt ou schéma : Un schéma fixe les noms et les types de champs avant l'appel, de sorte que la réponse ne contient que les champs que vous avez nommés. Un prompt laisse la structure au modèle, ce qui est plus rapide à écrire mais peut varier d'un appel à l'autre.
- Formats par type de page :
product,menu,branding,audioetvideorenvoient une structure fixe définie par Firecrawl.productcouvre le titre, le prix, la disponibilité, les variantes et le prix soldé. Ils ne prennent aucun paramètre et s'exécutent sans LLM. deterministicJson: Prend un schéma et met en cache un extracteur généré par site, de sorte que les scrapings répétés évitent le LLM. Ne peut pas être combiné avec le formatjson.- Exécution par requête : Chaque appel transporte son propre prompt ou schéma et s'exécute au moment de la requête, de sorte que la sortie reflète la page telle qu'elle apparaît à ce moment-là et qu'il n'y a rien à enregistrer au préalable.
- Support des agents de codage : Serveur MCP et CLI officiels, avec des démarrages rapides pour Claude Code, Cursor, Codex CLI et Gemini CLI, plus un plugin Claude officiel.
- Agent : Firecrawl propose également un produit Agent où l'URL est facultative. Vous décrivez ce que vous voulez et l'agent navigue sur le web pour le trouver.
ScrapingBee utilise le même modèle sans état à appel unique que Firecrawl. La différence réside dans la manière dont vous décrivez ce que vous voulez.
- Trois modes d'extraction : ai_query pour un champ unique en langage naturel (renvoie une chaîne), ai_extract_rules pour un schéma JSON où chaque champ possède sa propre description, et une forme avancée de celui-ci avec des types, des enums et une sortie imbriquée.
- ai_selector : Passez un sélecteur CSS pour concentrer le LLM sur une partie spécifique de la page. Plus rapide et plus précis que de le laisser lire le DOM complet.
- Scraping classique dans le même appel : render_js pour les sites riches en JS, screenshot, extract_rules pour l'extraction CSS/XPath sans IA, et json_response pour obtenir HTML, cookies, XHR et iframes dans une seule enveloppe.
Comment choisir le bon outil pour votre pipeline ?
En pratique, le bon outil dépend moins des listes de fonctionnalités que de ce que votre pipeline fait des données au fil du temps. Quelques schémas méritent d'être gardés à l'esprit :
Scraping ponctuel ou occasionnel
Si vous avez juste besoin de données depuis une URL une seule fois et que vous acceptez de la décrire ou de passer un schéma à chaque fois, les APIs d'extraction IA one-shot sont la voie la plus rapide. Aucun scraper à construire, aucun schéma à enregistrer.
Scraping répété dans un pipeline
Si vous exécutez le même scraper encore et encore et avez besoin d'un endpoint stable qui renvoie le même schéma à chaque fois, ou si vous devez personnaliser les champs de données pour les URL souhaitées, une plateforme à construction unique et appels multiples convient mieux. Votre pipeline se contente de transmettre des URL et la forme de la sortie reste prévisible.
Combien de temps faut-il pour y parvenir
Le temps de construction varie selon l'approche. Écrire un scraper ou un actor à partir de zéro prend généralement de quelques jours à quelques semaines, car le crawler, le câblage des proxies et les nouvelles tentatives sont à votre charge. Les plateformes basées sur des prompts génèrent le schéma et le code en quelques minutes. Les outils basés sur l'enregistrement aboutissent aussi en quelques minutes, avec une configuration par pointer-cliquer au lieu d'un prompt. Les APIs d'extraction IA one-shot suppriment l'étape de construction ; la première réponse revient en un seul appel HTTP.
Site déjà couvert par un scraper prêt à l'emploi
Utiliser un scraper prêt à l'emploi pour les sites populaires est généralement plus rapide que d'en construire un vous-même, mais qui le maintient en état de marche dépend de son origine. Une bibliothèque maintenue par un fournisseur est mise à jour par celui-ci lorsque le site change.
Site non couvert par une solution prête à l'emploi
La question devient alors de savoir qui corrige les choses lorsque les mises en page changent. Construire le vôtre signifie que la maintenance vous incombe. Un outil basé sur l'enregistrement implique de réentraîner le robot lorsque les choses cassent. L'auto-réparation IA sur du code que vous possédez se situe entre les deux : la correction est proposée sur votre code existant, et vous l'approuvez avant sa mise en production.
Construire avec des agents de codage
Si votre workflow passe par Claude Code, Cursor ou Codex, il importe de savoir si l'outil expose une CLI ou une intégration MCP que l'agent peut piloter de bout en bout, ou si l'agent ne peut appeler qu'une simple HTTP API.
 Ajouter comme source préférée
Méthodologie du benchmark de web scraping IA
Pour constituer le dataset, nous avons sélectionné les 10 principaux sites de mode et d'habillement au monde à partir de Semrush. Pour chaque site, une seule page produit a été choisie, et la vérité terrain (prix et devise) a été enregistrée manuellement en visitant directement la page.
Cinq outils de scraping IA ont été testés : le Scrape API de Firecrawl, le Scraper Studio de Bright Data, l'IA Extract de ScrapingBee, l'actor IA Web Scraper d'Apify et l'IA Scraper d'Oxylabs IA Studio. Chaque fournisseur a reçu le même prompt d'une seule phrase : « Extrayez le prix et la devise du produit et renvoyez json. »
Chaque URL a été envoyée une seule fois à chaque fournisseur. Il n'y a eu ni nouvelles tentatives, ni solutions de repli, ni application de schéma, ni étapes de post-traitement. La réponse brute a été stockée telle quelle, exactement comme le fournisseur l'a renvoyée.
Pour la validation, la sortie JSON brute a été analysée avec une expression régulière pour retrouver le prix et la devise attendus. La correspondance des prix tolère des variations de format courantes telles que 26.49 et 26,49, 2 140 et 2140, ainsi que de petites différences de précision décimale. La correspondance des devises accepte soit le code ISO (USD), soit le symbole ($).
Deux indicateurs ont été suivis. Le taux de réussite est calculé pour chaque URL sous la forme d'un contrôle binaire indiquant si le prix a été renvoyé correctement et d'un autre pour la devise ; les deux sont ensuite moyennés pour produire un score de réussite unique pour chaque URL, puis les scores sont moyennés sur les dix URL pour chaque fournisseur. Le temps de réalisation de bout en bout est la durée écoulée entre la requête et la réponse, moyennée sur les dix URL. Pour Bright Data, la construction unique du collecteur est exclue.
Comment nous avons sélectionné ces outils
Nous avons inclus les outils qui utilisent l'IA, tels que les LLMs, le NLP ou les modèles de vision, pour interpréter la structure des pages sans règles codées en dur, ou pour extraire des données à partir d'un prompt. Nous avons exclu les bibliothèques généralistes sans IA intégrée, telles que Scrapy et Playwright, même si toutes deux sont largement utilisées pour le scraping.
Dans les sections précédentes, les outils sont regroupés selon leur fonctionnement plutôt que selon leurs utilisateurs. La ligne de partage se situe au niveau de l'endroit où le modèle s'exécute : les plateformes à construction unique résolvent la structure de la page une seule fois et stockent le résultat sous forme d'un scraper que vous appelez par ID, tandis que les APIs one-shot la résolvent à nouveau à chaque requête. Cette distinction détermine le coût, la cohérence de la sortie et qui corrige les choses lorsqu'un site change ; elle sépare donc les outils de manière plus utile qu'une division no-code contre développeurs.
FAQ
Oui. Les bibliothèques open source telles que Crawl4AI, Skyvern et Browser Use sont gratuit à auto-héberger, et la plupart des outils commerciaux, notamment Browse IA, Firecrawl et Thunderbit, proposent une offre gratuit avec des limites d'utilisation.
Citer cette recherche
Choisissez le format qui correspond à votre lieu de publication. Coller la version avec lien dans votre CMS préserve le lien retour.
@misc{sipi2026,
  author = {Şipi, Nazlı},
  title  = {{Meilleurs outils de web scraping IA benchmarkés}},
  year   = {2026},
  month  = aug,
  howpublished    = {\url{https://aimultiple.com/ai-web-scraping}},
  note   = {AIMultiple. Consulté le 25 août 2026}
}Résultats et horodatages de 56 points de données. Téléchargez les données de synthèse présentées dans les graphiques et les tableaux de cet article sous forme de fichier ZIP contenant 2 fichiers CSV et un README.
Vous voulez les données détaillées derrière ? Rejoindre Premium
Journal des modifications
5 mises à jourAjout d'une section de benchmark comparant les outils de web scraping IA sur les principaux sites e-commerce.
Remplacé la liste d'outils par des entrées nommées pour Browse AI, Firecrawl, ScrapeGraphAI, Diffbot, Kadoa, Skyvern et d'autres, et ajouté une section FAQ.
Remplacement de l'introduction aux outils de web scraping IA par une description des agents IA autonomes, du scraping basé sur la vision (VLM) et des scrapers auto-réparateurs.








Soyez le premier à commenter
Votre adresse courriel ne sera pas publiée. Tous les champs sont obligatoires. Les commentaires sont laissés dans leur langue d'origine.