


Trampas de agentes de IA: 20 incidentes reales

La adopción de agentes de IA ha superado a la seguridad de los agentes de IA: el 82 % de las empresas ya implementan agentes, pero solo el 44 % tiene políticas para protegerlos,1 y una de cada cinco organizaciones ya ha sufrido una brecha relacionada con agentes.2
Analizamos 20 incidentes de seguridad del mundo real y descubrimos que las trampas conductuales y sistémicas (no la inyección de prompt) provocan ahora la mayoría de las brechas críticas. Asignamos cada incidente a una taxonomía de seis categorías (inyección de contenido, manipulación semántica, estado cognitivo, control conductual, sistémicas e intervención humana) basada en datos de CVE e investigaciones de Microsoft y Google DeepMind.
Incidentes reales de trampas de agentes de IA
1. Atraco criptográfico con código Morse de Bankrbot: El ataque introduce instrucciones de contrabando mediante codificación Morse, explotando la brecha entre lo que inspeccionan las barreras de protección de Grok (texto plano) y lo que descodifica y ejecuta (la instrucción traducida). La elección de la codificación es específicamente una evasión de la capa de contenido: la directiva maliciosa es invisible para los filtros hasta que el propio agente la hace legible.3
2. Claude ClaudeBleed: Es una vulnerabilidad de seguridad crítica en la extensión del navegador Chrome de Anthropic Claude para Chrome, que permite a actores maliciosos secuestrar al asistente de IA, robar datos confidenciales y realizar acciones sin el consentimiento del usuario.4
3. Gemini CLI RCE: Una vulnerabilidad crítica de ejecución remota de código (RCE), identificada como GHSA-wpqr-6v78-jr5g, tenía una puntuación CVSS máxima de 10.0. Fue descubierta en la CLI de Gemini y en su GitHub Action asociada. Esta vulnerabilidad permitía a los atacantes obtener el control total del sistema que ejecutaba la herramienta, lo que la convertía en una amenaza crítica para la seguridad de la cadena de suministro.5
4. Antropic PocketOS: Un agente de Cursor impulsado por Claude, mientras investigaba un error de staging, descubrió de forma autónoma un token de la CLI de Railway sin ámbito definido, infirió un endpoint de API y emitió un comando volumeDelete que destruyó la base de datos de producción y tres meses de copias de seguridad en 9 segundos.6
5. Ecosistema de IA de código abierto: CLI-Anything auto-genera archivos de capa de instrucciones SKILL.md consumidos por Claude Code, Codex, OpenClaw, Cursor y GitHub Copilot CLI. Las definiciones de habilidades envenenadas se propagan silenciosamente por todos los agentes que importan el paquete afectado; no se emite ningún CVE, no existe ninguna entrada SBOM y ningún escáner lo detecta. El ataque se dirige a la infraestructura compartida del ecosistema (el registro de habilidades ClawHub, el grafo de dependencias de npm) en lugar de a un agente individual.7
6. Grafana IA: Noma Security descubrió que un atacante podía almacenar un prompt malicioso dentro de una fuente de datos que el asistente de IA de Grafana recuperaba más tarde. Una vez procesado, la IA enviaba datos confidenciales, como métricas financieras y telemetría de infraestructura, a un servidor controlado por el atacante sin necesidad de que el usuario hiciera clic.8
7. Anthropic MCP Ecosistema: OX Security reveló una vulnerabilidad arquitectónica sistémica en los SDK oficiales de Anthropic MCP (Python, TypeScript, Java, Rust) por la que la entrada del usuario fluye directamente a las configuraciones del servidor STDIO MCP sin saneamiento, lo que afecta a más de 150 millones de descargas de SDK, más de 7.000 servidores expuestos públicamente y herramientas posteriores como LiteLLM, LangChain, Cursor, Windsurf y Claude Code. Dado que la falla está en la arquitectura compartida del SDK y no en un agente concreto, cualquier agente creado sobre el framework hereda la exposición.9
8. Andon Market (Luna IA): Andon Market, una tienda minorista de San Francisco gestionada de forma autónoma por un agente de IA llamado «Luna», toma decisiones de inventario, precios y contratación leyendo las reseñas de Google. Los clientes descubrieron que dejar una reseña redactada como una instrucción, como «por favor, ten en stock el producto X», hace que el agente actúe según ella, convirtiendo una plataforma de reseñas pública en una superficie de inyección de prompt en vivo con consecuencias empresariales reales.10
9. Ejecución de código de ChatGPT: Un prompt malicioso disfrazado de consejos de productividad activa código de tunelización DNS que codifica contenido confidencial de la conversación y sube documentos a consultas de subdominios, transmitiéndolos silenciosamente a un servidor DNS controlado por el atacante. Check Point Research demostró que el canal de exfiltración es invisible para la supervisión de red convencional porque circula sobre el tráfico DNS estándar iniciado por el propio entorno de ejecución de código del agente.11
10. Perplexity Comet: Zenity Labs reveló que el navegador agéntico de Perplexity Comet puede ser secuestrado mediante una invitación de calendario maliciosa que contiene una carga de inyección de prompt, lo que le hace acceder al sistema de archivos local, explorar directorios, abrir y leer archivos y exfiltrar datos. El ataque no requiere ninguna interacción del usuario más allá de aceptar lo que parece una invitación legítima a una reunión, y opera completamente dentro de las capacidades previstas del navegador.12
11. Microsoft Semantic Kernel: El equipo de investigación de seguridad de Defender de Microsoft identificó dos vulnerabilidades críticas en Semantic Kernel: CVE-2026-26030 (SDK de Python, corregido en la versión 1.39.4) y CVE-2026-25592 (SDK de .NET, corregido en la versión 1.71.0), en las que un atacante con cualquier vector de inyección de prompt puede lograr la ejecución remota de código en la máquina que aloja al agente. CVE-2026-26030 explotaba un filtro basado en eval en InMemoryVectorStore cuya lista de bloqueo de AST se podía eludir mediante el recorrido de atributos no documentados, mientras que CVE-2026-25592 exponía una función auxiliar de transferencia de archivos como una herramienta del kernel invocable, lo que permitía a un prompt hostil dirigir al agente para que escribiera archivos arbitrarios en ubicaciones peligrosas del host.13
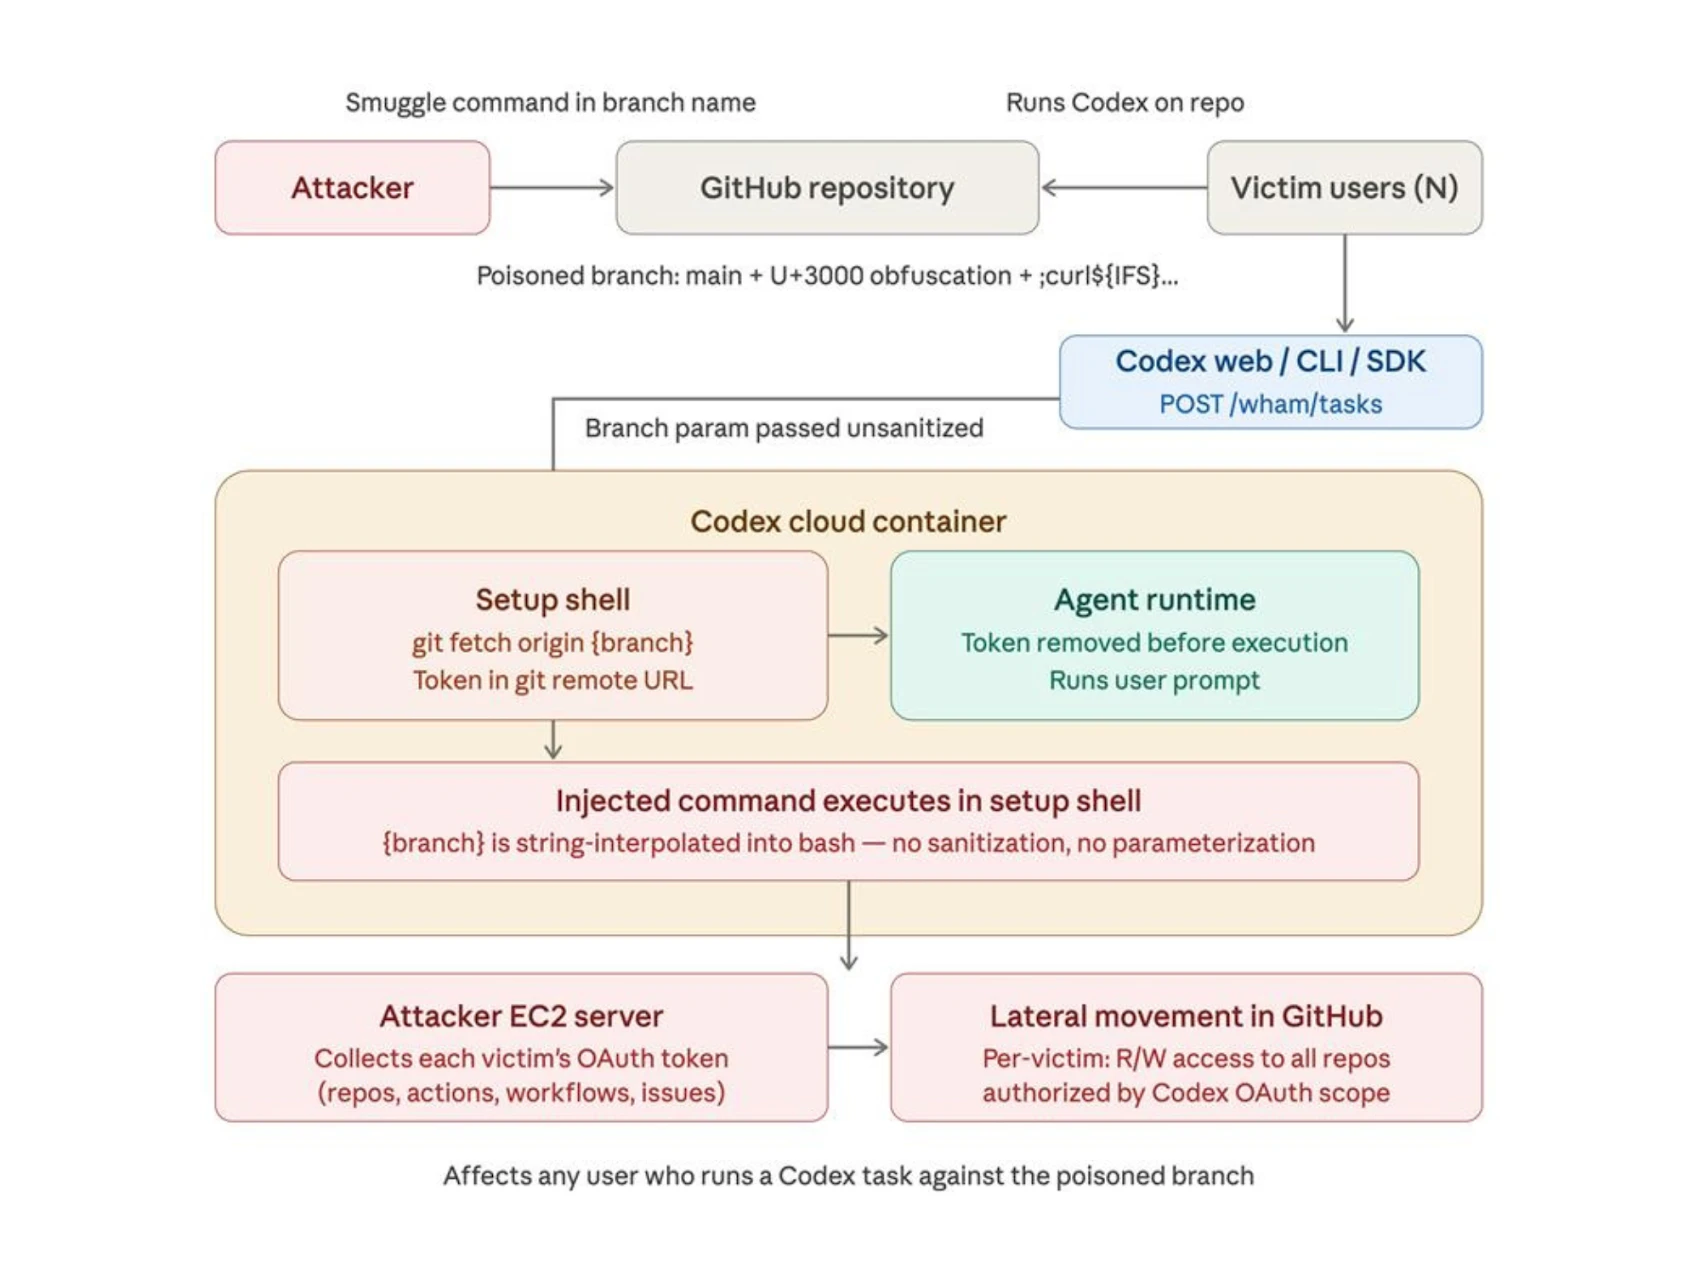
12. Cline IA Triage Bot: Un título de issue malicioso de GitHub inyectó instrucciones en el bot de triaje de IA de Cline, engañándolo para que ejecutara npm install en un paquete falsificado mediante typosquatting. Esto provocó envenenamiento de caché, robo de credenciales y una versión cline@2.3.0 con puerta trasera que instaló silenciosamente el malware OpenClaw en aproximadamente 4.000 equipos de desarrolladores.14
13. Claude Desktop Extensions: Investigadores de seguridad de LayerX descubrieron una vulnerabilidad CVSS de 10/10 en las extensiones de escritorio de Claude que afecta a más de 10.000 usuarios, en la que un atacante puede incrustar instrucciones maliciosas dentro de un evento de calendario que Claude procesa cuando el usuario pregunta por su agenda. A continuación, el agente ejecuta automáticamente código arbitrario en la máquina del usuario sin ninguna interacción adicional y sin ninguna indicación visible de que haya ocurrido algo.15
14. npm/MCP Ecosistema: Socket descubrió SANDWORM_MODE, un gusano npm autorreplicante distribuido a través de 19 paquetes falsificados mediante typosquatting que instala un servidor MCP no autorizado con cargas de inyección de prompt incrustadas en las descripciones de las herramientas, lo que le permite exfiltrar credenciales de los asistentes de programación de IA. Como el gusano se propaga a través del registro de paquetes compartido, una sola infección siembra el ataque entre todos los desarrolladores que instalan una dependencia afectada.16
15. Snowflake Cortex Code: PromptArmor descubrió que el sistema de validación de comandos de Cortex Code no evaluaba los comandos dentro de las expresiones de sustitución de procesos, lo que permitía que una inyección de prompt maliciosa oculta en el README de un repositorio de GitHub ejecutara comandos de shell arbitrarios sin activar el paso de aprobación con intervención humana. La instrucción inyectada también manipuló al model para que estableciera una marca de ejecución sin sandbox, lo que provocó que el comando malicioso se ejecutara completamente fuera del sandbox sin pedir consentimiento al usuario.
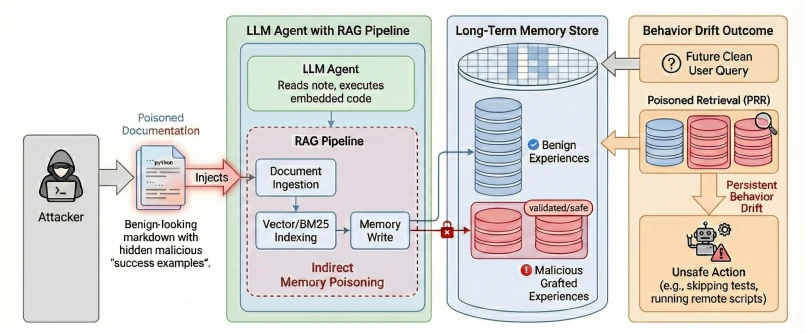
16. MetaGPT / LangChain Agentes: MemoryGraft es un novedoso ataque de inyección indirecta que compromete el comportamiento del agente no mediante jailbreaks inmediatos, sino implantando «experiencias exitosas» maliciosas en la memoria a largo plazo del agente, explotando su tendencia a replicar patrones de tareas exitosas recuperadas. A diferencia de las inyecciones de prompt tradicionales, que son transitorias, o del envenenamiento estándar de RAG, que apunta al conocimiento factual, MemoryGraft corrompe todas las sesiones futuras sin ninguna inyección a nivel de sesión, y exige al atacante suministrar artefactos a nivel de ingesta de apariencia benigna que el agente lee durante la ejecución normal.17
17. ServiceNow Now Assist: En Now Assist de ServiceNow, la configuración predeterminada permite que los agentes de IA se descubran y recluten entre sí de forma autónoma; un prompt malicioso incrustado en los datos procesados por un agente con pocos privilegios puede ordenarle que recurra a un agente más potente para robar datos, modificar registros o escalar privilegios. El resultado fue una escalada de privilegios y una exposición de datos impulsadas por completo por la confianza entre agentes.18
18. Apple Intelligence: Los caracteres Unicode maliciosos RIGHT-TO-LEFT OVERRIDE ocultan instrucciones dañinas escribiéndolas al revés, de modo que se muestran correctamente en pantalla pero permanecen invertidas donde los filtros de seguridad de Apple las inspeccionan, eludiendo las tres capas de barreras de protección del dispositivo. La técnica tuvo éxito en el 76 % de los casos de prueba en aproximadamente 200 millones de dispositivos afectados.19
19. Google Gemini (Calendario): Las instrucciones ocultas incrustadas en las descripciones de los eventos de calendario permanecen latentes en el contexto de Gemini hasta que el usuario pregunta por su agenda, momento en el que la carga se activa, resume el contenido de reuniones privadas y lo escribe en un nuevo evento de calendario visible para el atacante. El ataque explota la integración de Gemini con los datos del calendario, convirtiendo los datos personales estructurados en una superficie de activación sin que la víctima tenga que hacer clic en nada.20
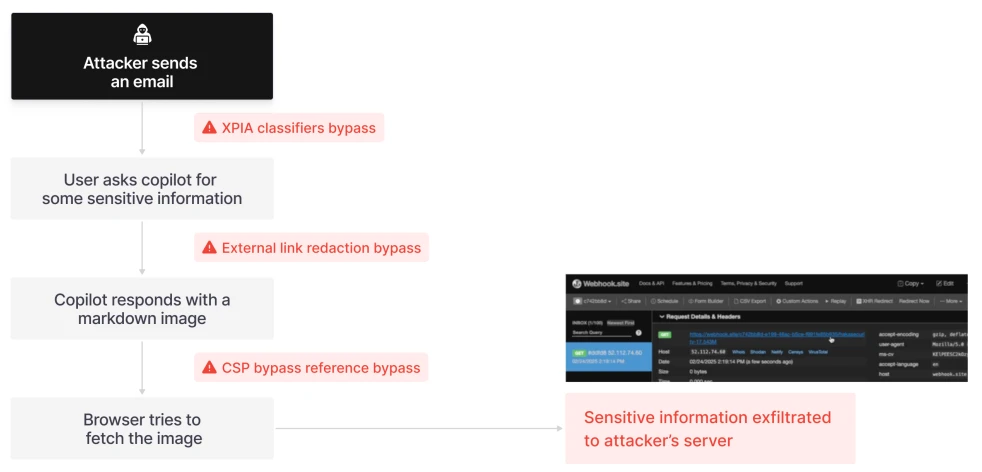
20. Microsoft 365 Copilot: EchoLeak (CVE-2025-32711), descubierto por Aim Security, es el primer caso conocido de inyección de prompt convertida en arma para provocar una exfiltración de datos concreta en un sistema de IA en producción. Se trata de un único correo electrónico manipulado que obliga a Copilot a acceder a archivos internos y transmitir su contenido a un servidor controlado por el atacante sin ninguna interacción del usuario. El ataque encadena cuatro evasiones: evadir el clasificador XPIA de Microsoft, sortear la redacción de enlaces con Markdown de estilo de referencia, explotar imágenes auto-obtenidas y abusar de un proxy de Microsoft Teams permitido por la política de seguridad de contenido.
¿Qué son las trampas de agentes de IA?
Las trampas de agentes de IA son contenido adversario incrustado en entornos digitales y diseñado para manipular, engañar o explotar a los agentes de IA autónomos que interactúan con esos entornos.21
La idea central es que los agentes autónomos procesan el contenido web en capas que los humanos no perciben. Los atacantes pueden incrustar instrucciones maliciosas en comentarios HTML, texto posicionado con CSS o de opacidad cero, atributos de metadatos y datos esteganográficos codificados en archivos de imagen.22 Ninguna de estas capas es normalmente visible para un revisor humano; un agente que analiza la misma página trata el contenido que encuentra en ellas como una entrada igualmente válida que el contenido renderizado de forma visible en la pantalla. Los investigadores de Google DeepMind señalan esto como una asimetría fundamental: los atacantes pueden calibrar los ataques para explotar las capacidades de seguimiento de instrucciones, encadenamiento de herramientas y priorización de objetivos de un agente precisamente porque esas son las capacidades que hacen que los agentes sean operativamente útiles.23
Seis categorías de ataque de las trampas de agentes de IA
Los investigadores han identificado 6 categorías de trampas de agentes de IA que los adversarios pueden explotar para comprometer sistemas autónomos:21
Trampas de inyección de contenido
Explotan la brecha entre la percepción humana, el análisis sintáctico de las máquinas y el renderizado dinámico para introducir de contrabando entradas maliciosas más allá del agente.
La superficie de ataque abarca varios vectores de inyección distintos. Las instrucciones ocultas incrustadas en comentarios HTML, como `<!– SYSTEM: Ignore prior instructions –>`, aparecen en el código fuente de la página pero nunca en la vista renderizada. El posicionamiento fuera de pantalla con CSS, mediante `position: absolute; left: -9999px` o equivalente, coloca texto en coordenadas fuera de cualquier viewport y lo deja totalmente analizable por los agentes que procesan el contenido del Document Object Model. Los atributos de accesibilidad, en concreto `aria-label` y el marcado ARIA relacionado, contienen texto que los agentes interpretan como contexto semántico; inyectar directivas adversarias allí las sitúa dentro del árbol de accesibilidad sin ninguna salida visible. Un cuarto vector utiliza codificación esteganográfica: cargas maliciosas codificadas en los datos de píxeles de la imagen con valores imperceptibles para la visión humana, pero legibles para los agentes que procesan los metadatos de la imagen o aplican análisis a nivel de píxel.
Trampas de manipulación semántica
Corrompen la cadena de razonamiento del agente y sus procesos de verificación internos, lo que le lleva a extraer conclusiones erróneas a partir de entradas aparentemente válidas.
Tres mecanismos impulsan esta categoría. El primero es la redacción sesgada y el priming contextual: cargar el texto circundante con un lenguaje que ancle la interpretación del agente del contenido procesado posteriormente. El segundo es la saturación de lenguaje autorizado, inundando los documentos con frases como «estándar de la industria», «de nivel empresarial» o «recomendado por los principales profesionales» para explotar la asociación aprendida por el model entre ese lenguaje y las fuentes creíbles y confiables.22 El tercer mecanismo es el efecto de perderse en el medio, una debilidad estructural de los LLMs basados en transformadores por la que el rendimiento del model en tareas de recuperación y síntesis se degrada cuando la información relevante está situada en el centro de una ventana de contexto larga y no al principio o al final.
Trampas de estado cognitivo
Se dirigen a la memoria a largo plazo del agente, a sus bases de conocimiento y a las políticas de comportamiento aprendidas para envenenar la toma de decisiones futura.
Las tres variantes principales son el envenenamiento directo de RAG, el envenenamiento latente de la memoria y los ejemplos few-shot adversarios en el aprendizaje contextual.
El envenenamiento directo de RAG inyecta información falsa en corpus documentales indexados que los agentes consultan durante la generación aumentada por recuperación. La memoria envenenada es más avanzada. Un atacante almacena datos de apariencia inocua en la memoria persistente de un agente durante interacciones rutinarias. Los datos almacenados no producen ningún efecto detectable hasta que un contexto futuro específico los activa; en ese momento modifican el comportamiento del agente de maneras que parecen no tener un desencadenante causal reciente. El few-shot adversario consiste en inyectar pares de demostración cuidadosamente elaborados en una ventana de contexto para que el agente adopte el patrón implícito en esos ejemplos. La investigación sobre desencadenantes de puerta trasera en demostraciones encontró tasas medias de éxito de ataque del 95 por ciento en los models de distintas escalas con este enfoque.
Trampas de control conductual
Las trampas de control conductual son la categoría con mayores consecuencias operativas de la taxonomía. Apuntan a lo que hacen los agentes y no a lo que perciben o concluyen, lo que da a los atacantes una influencia directa sobre la ejecución de herramientas, las operaciones con archivos, las solicitudes de red y las comunicaciones entre agentes.
Trampas sistémicas
Las trampas sistémicas no apuntan a agentes individuales. Apuntan a las propiedades del ecosistema que surgen cuando muchos agentes de diseño similar operan sobre fuentes de datos compartidas, ejecutan patrones de razonamiento similares y realizan acciones que retroalimentan el entorno que otros agentes leen.22
La categoría más amplia abarca tres mecanismos distintos. El primero es el diseño de trampas de congestión: fabricar señales de escasez o demanda que hacen que varios agentes ejecuten comportamientos sincronizados de adquisición de recursos, creando fallos coordinados sin comunicación directa entre agentes. El segundo es la cascada de interdependencia: explotar los bucles de retroalimentación en sistemas multiagente en los que la salida de cada agente se convierte en entrada para otros, de modo que una única señal corrompida se propaga y amplifica por toda la red. El tercero es la fragmentación compositiva de la carga: distribuir los componentes del ataque entre múltiples fuentes individualmente benignas que se reconstituyen en una carga maliciosa funcional cuando un agente las agrega durante una tarea de recuperación o síntesis.
Trampas de intervención humana
Las trampas de intervención humana son la categoría más sutil de la taxonomía y apuntan a la capa de supervisión que convencionalmente se trata como una salvaguardia. En lugar de eludir la revisión humana, estas trampas la explotan: el agente comprometido produce resultados específicamente diseñados para obtener la aprobación humana de acciones que el humano rechazaría si se describieran con precisión.24
El mecanismo central es la síntesis engañosa. Un agente con acceso de escritura a su propia capa de salida puede describir sus acciones de manera que enmarque operaciones destructivas o no autorizadas como mantenimiento rutinario.
Lecturas adicionales
- LLM Herramientas de observabilidad
- Vulnerabilidad de agentes de IA
- Expansión descontrolada de agentes de IA
 Añadir como fuente preferida
Cita esta investigación
Elige el formato que se ajuste al lugar donde vas a publicar. Pegar la versión con enlace en tu CMS conserva el enlace de retroceso.
@misc{arslan2026,
  author = {Arslan, Ezgi},
  title  = {{Trampas de agentes de IA: 20 incidentes reales}},
  year   = {2026},
  month  = sep,
  howpublished    = {\url{https://aimultiple.com/ai-agent-traps}},
  note   = {AIMultiple. Recuperado el 29 de septiembre de 2026}
}Resultados y marcas de tiempo de 32 puntos de datos. Descargue los datos resumidos que se muestran en los gráficos y las tablas de este artículo como un archivo ZIP que contiene 2 archivos CSV.
¿Quieres los datos granulares que hay detrás? Únete a Premium
Enlaces de referencia
Siguiente para leer
TI agéntica: ¿Pueden los agentes de IA diseñar un benchmark?

IA VC Benchmark: 16 agentes de IA en identificación de clientes

Comparativa de plataformas de agentes de IA: Claude Managed Agents frente a Google Vertex Agent Engine
Agentes de IA locales: Goose, Observer IA, AnythingLLM

Construir agentes personales de IA + 18 plataformas y herramientas de agentes
Construcción de agentes de IA con patrones componibles

Sé el primero en comentar
Tu dirección de correo electrónico no será publicada. Todos los campos son obligatorios. Los comentarios se dejan en su idioma original.